游戏建模进阶:ZBrush动态拓扑与面数控制,高精度模型流畅优化方法
- 定义: 动态拓扑是指在雕刻过程中由软件实时增加或减少网格密度,使笔刷经过之处自动获得足够网格支撑的技术;面数控制则是指在保证细节的前提下把总网格量压在可流畅操作的范围内的做法。两者合起来管的是"网格该在哪里变密"。
- 一句话理解: 动态拓扑的本质是把网格密度按需分配——只在正在雕刻的位置加密,而不是整个模型一起加密。
- 为什么重要: 高模的卡顿几乎都不是硬件不够,而是网格分配不合理。在不需要细节的部位维持高密度网格,会持续消耗内存与运算,最终让整台机器在几千万点的模型前失去响应。
- 核心观点: 顺序是先用动态拓扑把大形做准(不纠结网格)→ 再转常规细分做结构→ 最后只在必要区域提高层级。反过来(一上来就细分到高层级再雕大形)会让每一次大形调整都变成一次全模型的运算。
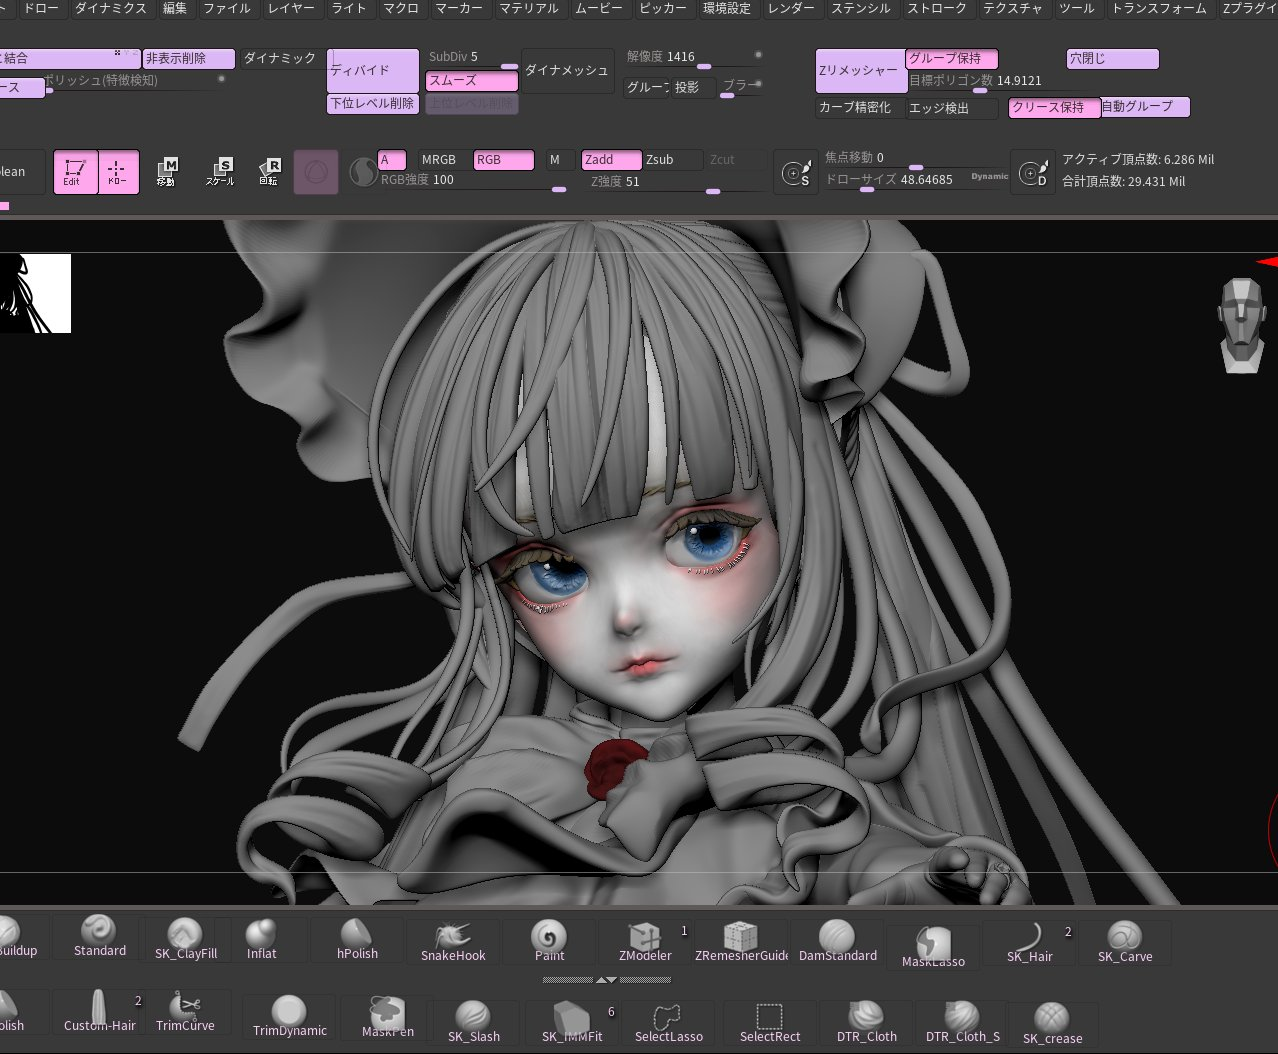
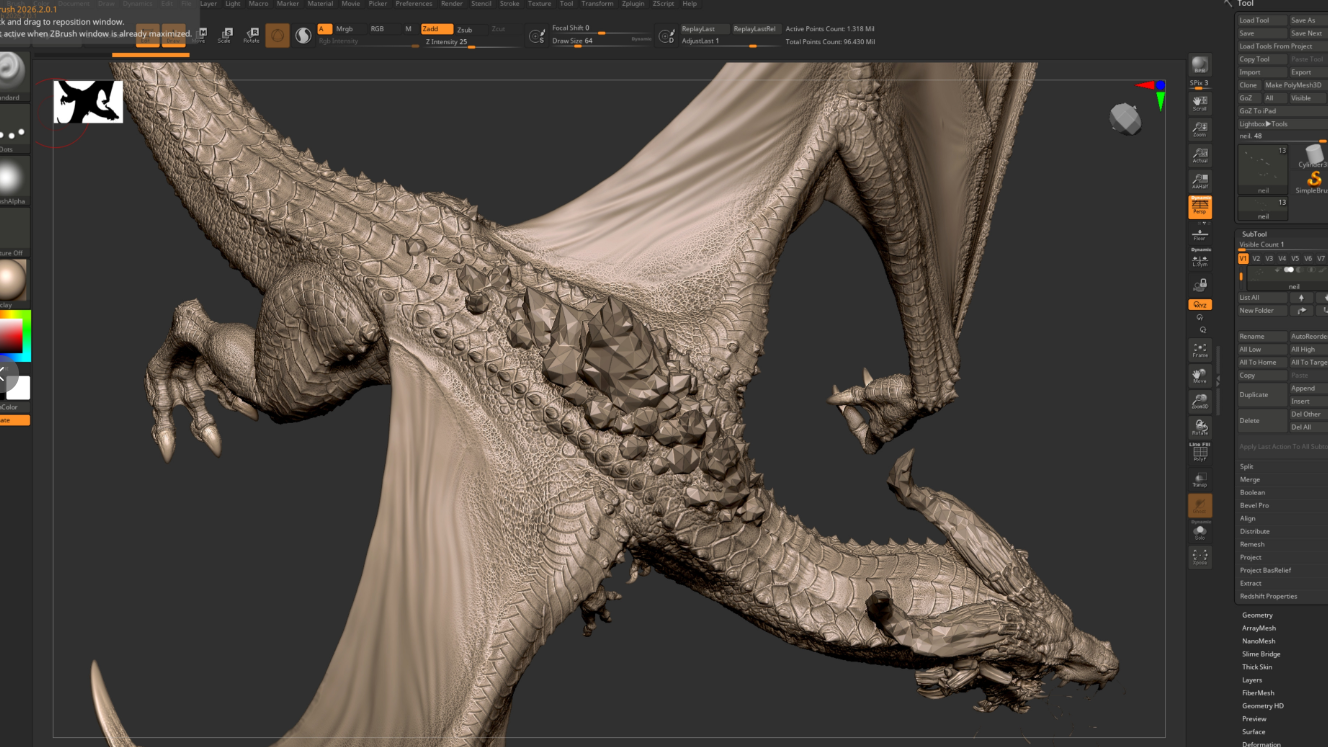
- 典型场景: 一个角色的头部雕到一半开始明显卡顿,检查后发现整个头部——包括后脑与脖颈这些最终会被遮挡的位置——都被细分到了最高层级,真正需要高密度的只有面部区域。
- 适用对象: 本文面向已经能独立完成雕刻、开始被高模性能问题拖慢的进阶建模师。
- 本文内容: 拆解卡顿的真实来源、动态拓扑的开关时机、细分层级与图层的作用、工作性能的实操设置,以及一套面数与性能自检方法。
一、卡顿的来源:不是面数而是网格结构
总面数只是表象,真正决定操作流畅度的是单次运算要处理多少网格。
1.1 单次笔刷的计算量
每一次落笔,软件只需要计算笔刷覆盖范围内的网格。
因此流畅度取决于"笔刷直径内有多少网格",而不是全模型的总点数。这解释了一个现象:一个两千万点的模型可以在某个区域很流畅、在另一个区域很卡——卡的那个区域网格密度过高。
推论是明确的:降低全模型面数并不总能解决卡顿,把不需要高密的区域的层级降下来才有效。
1.2 三类额外的性能开销
除了笔刷运算,还有三类开销会叠加。
- 撤销历史:每一步操作都被记录,历史层数越多占用越大,这是长时间作业后越来越卡的主因;
- 显示与预览:阴影、环境光遮蔽预览、材质反射都会在每次操作后重算;
- 多子工具同时显示:所有可见的子工具都要参与绘制,即使当前只编辑其中一个。
这三类开销与面数无关,却常常是"明明面数不高却很卡"的原因。
1.3 硬件与软件的分界
先排除软件设置,再考虑升级硬件。
判断方法:新建一个空场景只放一个球体,逐步提高细分并观察在多少点时开始卡顿。如果这个数字远低于该机型的常见水平,问题在设置而不在硬件。
卡顿来源与总面数的关系优先处理方式笔刷范围网格过密无关,取决于局部密度降低该区域细分层级撤销历史堆积无关减少历史层数、用图层替代显示与预览开销无关关闭阴影与遮蔽预览多子工具同时显示部分相关隐藏当前不编辑的子工具全模型总点数过高直接相关检查是否有区域密度冗余
结论: 卡顿来源三项要点——流畅度取决于笔刷范围内的网格密度而非总面数(同一模型不同区域流畅度可以完全不同;降低全模型面数不一定有效)、三类额外开销与面数无关(撤销历史堆积、显示预览重算、多子工具同时显示,是"面数不高却很卡"的常见原因)、先用空场景实验排除设置问题(新建球体逐步提高细分,若卡顿点远低于该机型常见水平则问题在设置)。
二、动态拓扑:什么时候开、什么时候关
动态拓扑是塑形阶段的利器,但它与细节阶段的目标相反。
2.1 两种动态拓扑的分工
主流工具提供两种动态细分方式,适用场景不同。
- 整体重建型:用均匀网格重新生成整个模型,适合大形阶段与布尔合并之后,能让形体在任意拉伸下都保持均匀网格;
- 局部追踪型:笔刷经过处实时增减网格,适合连续的有机塑形,网格会跟着笔刷走。
整体重建型的代价是丢失原有细分层级与 UV,局部追踪型则保留已有的细节层级。因此大形用前者、细化用后者是常见组合。
2.2 塑形阶段的开法
大形阶段应当开着动态细分,并且不要顾虑网格。
这一阶段的目标是形体准确,网格均匀与否、面数多少都不重要,因为最终会被重建。很多人在这个阶段就开始心疼面数,结果大形迟迟做不准,反而浪费更多时间。
建议做法是先把剪影与体块推到满意,再统一重建一次网格,把不均匀的拉伸一次性抹平。
2.3 细节阶段的关法
进入结构细化阶段后应关闭动态细分,改用常规细分层级。
原因是两者目标冲突:动态细分会不断改变网格结构,而细节雕刻需要稳定的网格作为基础——网格一变,之前雕好的细微起伏就会被重新采样而模糊。
判断切换时机的方法是看"是否还在改大形":一旦连续若干次操作都只在做表面起伏而不改变轮廓,就该切换了。
结论: 动态拓扑三项要点——整体重建型适合大形与布尔合并,局部追踪型适合连续有机塑形(前者会丢失细分层级与 UV,后者保留已有层级)、塑形阶段应开着且不顾虑面数(大形阶段网格终将被重建;过早心疼面数会让大形迟迟做不准)、进入细节阶段必须关闭并改用固定细分(动态细分会改变网格结构,使已雕好的细微起伏被重新采样而模糊)。
三、细分层级与图层:把可回退性做进文件
高模制作的最大成本往往不是雕刻,而是改不动。
3.1 各层级的密度与分工
每提高一级细分,网格数量约变为原来的四倍。
因此层级之间的密度差是急剧的:从第三级到第六级,网格量会相差数十倍。这决定了各层级的合理分工:低层级做大形与比例、中间层级做结构转折、高层级只做表面细节。
关键纪律是低层级的问题必须在低层级解决。在高层级上调整大形,会拉伸出明显的网格痕迹,且这些痕迹很难清理。 笔刷参数与细分层级如何配合,见ZBrush高阶雕刻笔刷运用。
3.2 图层替代反复撤销
用图层记录可选的形变,比依赖撤销历史更省资源也更可控。
做法是把某一处改动单独放在一个图层上,通过调整图层强度来控制它的强弱。这样既不需要保留大量历史步骤,也能随时把某一处改动减弱或关闭。
图层的另一个价值是并行尝试:同一个位置做两种方案,分别放在两个图层上,通过开关强度对比效果,而不需要雕两遍。
3.3 隐藏与分组减少运算
隐藏当前不编辑的部分,是提升流畅度最直接的手段。
典型做法:逐个子工具编辑,编辑时隐藏其余;在单个子工具内部用遮罩或隐藏功能圈定工作区域。
这一条的效果常被低估:把可见网格量降到三分之一,操作流畅度的改善往往比升级硬件更明显。
结论: 细分与图层三项要点——每级细分约四倍网格且层级分工明确(低层做大形、中层做结构、高层只做细节;在高层级调整大形会拉伸出难以清理的网格痕迹)、用图层替代反复撤销(图层可调强度、可关闭、可并行对比两种方案,同时避免历史堆积)、隐藏不编辑的部分是最直接的提速手段(把可见网格量降到三分之一,改善往往比升级硬件更明显)。
四、工作性能的实操设置
这些设置不改变模型,只改变操作体验。
4.1 先关掉实时预览
阴影、环境光遮蔽、材质反射这三类实时预览会在每次操作后重算。
在塑形与雕刻阶段它们对判断帮助有限,却持续消耗资源。 建议在大形阶段关闭全部实时预览,只在阶段验收时临时打开确认体积关系。 体积与光影的判断方法见光影逻辑职业化。
4.2 控制撤销历史深度
撤销历史是长时间作业后变卡的首要原因。
建议把历史层数设在一个够用的低值,并养成阶段性手动清理的习惯。需要保留的可选改动改用图层承载,这样即使历史被清理,重要改动也不会丢失。
4.3 按子工具拆分并管理
把模型拆成合理的子工具,是性能与可控性的双重优化。
拆分依据是"是否会被独立调整":盔甲、布料、配件、皮肤应各自独立,这样既能单独隐藏以提高流畅度,也便于后续单独导出与烘焙。子工具数量过多时需要分组管理,否则寻找与切换的成本会抵消拆分带来的收益。
结论: 性能设置三项要点——先关闭实时预览(阴影、遮蔽、反射在每次操作后重算,塑形阶段对判断帮助有限)、控制撤销历史深度并用图层承载可选改动(历史堆积是长时间作业后变卡的首要原因;图层不随历史清理而丢失)、按是否会被独立调整拆分子工具(拆分便于隐藏提速与单独烘焙;数量过多时需分组管理)。
五、面数与性能自检
自检同时针对操作流畅度与最终资产质量。
5.1 局部密度检查
把模型转到线框显示,观察各区域的网格疏密。
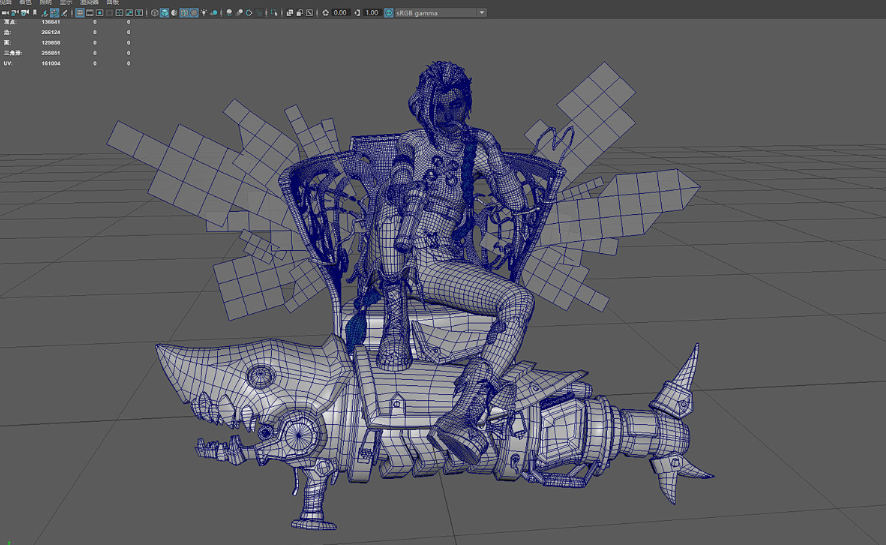
重点看三处:最终会被遮挡的位置(后脑、腋下、模型内部)、大面积平坦区域、笔刷密集涂抹过的区域。这三处是高密度冗余的高发位置。
5.2 层级使用检查
逐级回退,确认形体在低层级上已经定稿。
在低层级观察时,大形与比例应当已经成立。如果低层级看上去含糊、只有到高层级才像样,说明形体没有在低层级解决,后续任何大形改动都会牵连全部细节。
5.3 图层与历史检查
检查是否存在大量未整理的图层与过深的历史记录。
图层应有明确命名与用途,未使用的应删除。图层数量失控本身也会带来开销,且会让文件难以交接。
5.4 导出前检查
确认最终用于烘焙的高模已经做了必要清理。
检查三项:是否删除了隐藏的多余子工具、是否移除了用于测试的临时形体、总点数是否在烘焙软件可承受的范围内。其中总点数最容易被忽略——很多烘焙失败的直接原因就是高模点数超出烘焙工具的处理上限,具体的高模整理方法见模型减面优化高阶技巧。
结论: 性能自检四项——局部密度检查(线框显示下重点看被遮挡位置、大面积平坦区、密集涂抹区)、层级使用检查(低层级观察时大形与比例应已成立,只有高层级才像样说明形体没在低层解决)、图层与历史检查(图层应有命名与用途,数量失控本身也带来开销并影响交接)、导出前检查(删除隐藏子工具与临时形体,确认总点数在烘焙工具可承受范围内)。
常见问题 Q&A
Q1:ZBrush 雕到一半开始卡顿,是不是只能升级硬件?
不一定,先排查软件设置。真正决定操作流畅度的不是总面数,而是笔刷直径内有多少网格,因为每一次落笔软件只需要计算笔刷覆盖范围内的网格,所以一个两千万点的模型可能在这个区域很流畅、在另一个区域很卡,卡的那个区域网格密度过高。
除了笔刷运算,还有三类与面数无关的开销会叠加:撤销历史堆积,每一步操作都被记录、历史层数越多占用越大,这是长时间作业后越来越卡的主因;显示与预览开销,阴影、环境光遮蔽预览、材质反射都会在每次操作后重算;多子工具同时显示,所有可见的子工具都要参与绘制。判断问题在设置还是硬件有个简单方法:新建空场景只放一个球体,逐步提高细分并观察在多少点时开始卡顿,如果这个数字远低于该机型常见水平,问题就在设置。
Q2:动态拓扑什么时候该开,什么时候该关?
大形阶段开着且不要顾虑面数,细节阶段关掉改用常规细分层级。塑形阶段的网格最终会被重建,所以均匀与否、面数多少都不重要,很多人在这个阶段就开始心疼面数,结果大形迟迟做不准反而浪费更多时间,建议先把剪影与体块推到满意再统一重建一次网格,把不均匀的拉伸一次性抹平。
进入结构细化阶段后两者目标就冲突了:动态细分会不断改变网格结构,而细节雕刻需要稳定的网格作为基础,网格一变之前雕好的细微起伏就会被重新采样而模糊。切换时机的判断方法是看是否还在改大形,一旦连续若干次操作都只在做表面起伏而不改变轮廓,就该切换了。另外主流工具提供两种方式,整体重建型适合大形与布尔合并但会丢失细分层级与 UV,局部追踪型保留已有层级、适合连续的有机塑形。
Q3:怎么判断高模的面数是不是浪费了?
把模型转到线框显示观察各区域的网格疏密,重点看三处:最终会被遮挡的位置,比如后脑、腋下、模型内部;大面积平坦区域;笔刷密集涂抹过的区域。这三处是高密度冗余的高发位置。举个典型的例子,一个角色的头部雕到一半开始明显卡顿,检查后发现整个头部包括后脑与脖颈这些最终会被遮挡的位置都被细分到了最高层级,而真正需要高密度的只有面部区域。另外要做层级回退检查,逐级退回低层级观察时大形与比例应当已经成立,如果低层级看上去含糊、只有到高层级才像样,说明形体没有在低层级解决,后续任何大形改动都会牵连全部细节。导出前还要确认删除了隐藏的多余子工具、移除了测试用的临时形体,并确认总点数在烘焙软件可承受范围内。
免责声明
本文由梵映教育教研团队原创撰写,旨在分享行业的技术认知与学习经验。文中涉及的软件操作、行业数据及职业发展建议均基于梵映教育教学实践经验整理,仅供参考,不构成任何形式的就业承诺或效果保证。行业技术迭代较快,具体学习路径请结合个人实际情况灵活调整。如需系统化学习指导,欢迎联系梵映教育专业顾问获取一对一规划建议。本文内容版权归梵映教育所有,未经授权不得转载、摘编或用于其他商业用途。
延伸阅读
如需系统化学习指导,欢迎联系梵映教育专业顾问获取一对一规划建议。